14. Kalenderdaten und Zeitreihen#
pandas unterstützt Kalenderdaten und Uhrzeiten als eigenen Datentyp. Dies bringt eine Reihe von Vorteilen und erweiterten Funktionalitäten gegenüber der Speicherung als String oder Behandlung als reinen Zahlenwert (auch wenn dies die Repräsentation im Speicher darstellt)):
Sortierung: nach Zeitstempeln kann von ältesten zu neuesten oder andersrum sortiert werden ohne auf eine entsprechende String-Repräsentation angewiesen zu sein (Stichworte: Reihenfolge und Vollständigkeit der Zeit- und Datumselemente, sowie führende Nullen)
Selektion: es kann z.B. auf alle Zeitstempel zugegriffen werden, die an einem bestimmten Tag oder in einem Monat sind.
Extraktion: es können auf Eigenschaften des Zeitstempels zugegriffen werden, z.B. auf den Wochentag oder die Minutenangabe
Resampling: wenn der Index aus Zeitstempeln besteht, dann kann mit der resample-Methode die Auflösung geändert werden, z.B. 1 Eintrag je Stunde oder Sekunde. Beim Sampling auf eine gröbere Auflösung (z.B. Tag zu Monat) werden die Werte aggregiert, beim Sampling auf eine feinere Auflösung (z.B. Stunde auf Minute) können die Daten interpoliert oder freigelassen werden
Generierung: es können bequem Zeitreihen generiert werden, wie z.B. alle Quartale der letzten und nächsten 3 Jahre
Timedelta: es können Differenzen zwischen Zeitstempeln erzeugt werden und automatisch in verschiedene Einheiten (z.B. Sekunden, Stunden, Tage) umgerechnet werden.
Verschiebung: Werte können um eine Anzahl von Zeilen oder um einen Zeitraum verschoben werden, z.B. um den Umsatz des Vortags als Feature für eine Prognose zu nutzen
Einen Überblick über die weitere Möglichkeiten und deren Anwendung gibt der pandas User Guide zu Time Series und zu Time Deltas.
Die Übungen und Beispiele basieren auf Daten über weltweite Systeme des öffentlichen Nahverkehrs von https://www.citylines.co
14.1. Konvertierung in Zeitstempel#
Wenn wir Daten auslesen sind Kalenderdaten/Zeitstempel oftmals in einer String-Repräsentation vorhanden. Der erste Schritt ist eine Konvertierung in den entsprechenden Datentyp.
Im Folgenden verwenden wir die Zuordnungsdatei von Sektionen zu Linien, da diese Zeitstempel enthält. Die Zeitstempel created_at und updated_at beziehen sich auf die Bearbeitung der Tabelleneinträge. Unsere Analyse in diesem Kapitel bezieht sich somit mehr auf den Datensatz und wie (bzw. eher wann) er erstellt wurde als inhaltlich auf die Städte und Liniennetze.
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import seaborn as sns
# Cached version of https://data.heroku.com/dataclips/egetzfbhwqhqjbpedplrgppjlerc.csv
# Datum: 19.07.2021
section_lines = pd.read_csv("data/section_lines.csv", index_col='id')
section_lines.head()
| section_id | line_id | created_at | updated_at | city_id | fromyear | toyear | line_group | |
|---|---|---|---|---|---|---|---|---|
| id | ||||||||
| 2494 | 1278 | 343 | 2017-11-21 00:00:00 | 2017-11-21 00:00:00 | 252 | NaN | NaN | 0 |
| 4124 | 4477 | 779 | 2017-11-21 00:09:55.135507 | 2017-11-21 00:09:55.135507 | 63 | NaN | NaN | 0 |
| 2495 | 21 | 9 | 2017-11-21 00:00:00 | 2017-11-21 00:00:00 | 1 | NaN | NaN | 0 |
| 2496 | 940 | 228 | 2017-11-21 00:00:00 | 2017-11-21 00:00:00 | 79 | NaN | NaN | 0 |
| 4129 | 4478 | 793 | 2017-11-21 17:44:39.765832 | 2017-11-21 17:44:39.765832 | 48 | NaN | NaN | 0 |
section_lines.dtypes
section_id      int64
line_id         int64
created_at        str
updated_at        str
city_id         int64
fromyear      float64
toyear        float64
line_group      int64
dtype: object
Wie wir sehen wurden sowohl created_at als auch updated_at als Strings (Datentyp object) importiert. In unserem Fall entsprechen die Strings dem Standardformat: Einheiten werden mit Jahr startend und Sekunde ended immer kleiner, es werden - als Datumstrennzeichen, : als Zeitrennzeichen verwendet. Dennoch ist es immer ratsam as Format explizit anzugeben (Parameter format). Hier ist ein weiterer Parameter notwendig exact=False, da einige Daten noch zusätzlich Nanosekunden enthalten und somit nicht exakt auf das Format passen. Wir verwenden die Konvertierungsfunktion pd.to_datetime:
section_lines['created_at'] = pd.to_datetime(section_lines['created_at'], format='%Y-%m-%d %H:%M:%S', exact=False)
section_lines['updated_at'] = pd.to_datetime(section_lines['updated_at'], format='%Y-%m-%d %H:%M:%S', exact=False)
section_lines.dtypes
section_id             int64
line_id                int64
created_at    datetime64[us]
updated_at    datetime64[us]
city_id                int64
fromyear             float64
toyear               float64
line_group             int64
dtype: object
Wir sehen den geänderten Datentyp. Oftmals ist es notwendig das Datenformat anzugeben, bzw. auch wenn es nicht notwendig ist, ist es hilfreich das Format anzugeben, um fehlerhafte Daten zu erkennen. Die Doku über die Parameter findet sich in der API Referenz und die Beschreibung der zu nutzenden Format-Strings in der Python-Doku.
Nun können wir über den Namespace dt einer Zeitstempel-Series auf weitere Funktionen zugreifen, z.B. die Formatierung als Datum in deutschem Format ohne Uhrzeit:
section_lines['created_at'].dt.strftime("%d.%m.%Y")
id
2494     21.11.2017
4124     21.11.2017
2495     21.11.2017
2496     21.11.2017
4129     21.11.2017
            ...
20585    10.07.2021
20586    10.07.2021
20587    10.07.2021
20588    11.07.2021
20589    17.07.2021
Name: created_at, Length: 16303, dtype: str
14.2. Eigenschaften von Zeitstempeln#
Dass absolute Datum oder die absolute Uhrzeit von Ereignissen sind häufig uninteressant, da sie jeweils nur einzeln vorkommen und somit keine Muster erkennbar sind. Stattdessen interessieren uns wiederkehrende Eigenschaften wie z.B. die Stunde der Uhrzeit. Im Folgenden erstellen wir eine Spalte für die Stunde, um zu sehen zu welchen Tageszeiten am meisten am Datensatz gearbeitet wurde.
# Extraktion der Stunde per dt-Accessor aus der Series
# Abspeichern in neuer Spalte
section_lines['hour'] = section_lines['created_at'].dt.hour
# Gruppierung auf der neuen Spalte je Stunde und zählen der Einträge (size)
section_lines.groupby('hour').size().plot()
plt.show()
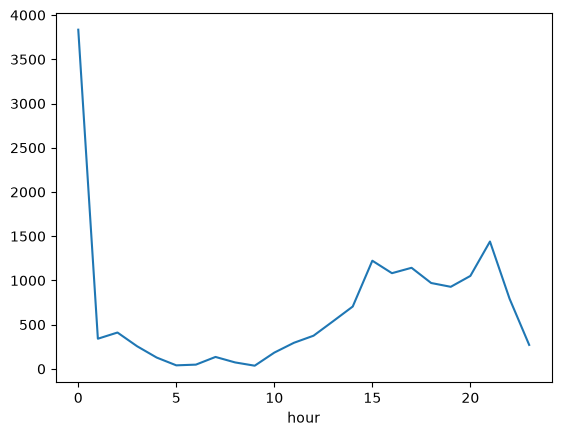
Wie wir sehen wurde der größte Teil der Dateneinträge um 0 Uhr gemacht. Wir wollen uns diese Einträge genauer anschauen. Dazu filtern wir die Tabelle auf alle Einträge der Stunde 0 und schauen, dann an welchen Tagen wir wie viele dieser Einträge haben.
section_lines.loc[section_lines['hour'] == 0, 'created_at'].dt.strftime('%Y-%m-%d').value_counts().head(10)
created_at
2017-11-21    3577
2021-01-05      41
2018-02-04      38
2020-12-28      25
2020-11-04      18
2021-02-14      18
2021-01-27      14
2021-02-11      14
2021-03-15       8
2020-04-05       7
Name: count, dtype: int64
Es fällt auf, dass die meisten dieser Einträge auf einen einzelnen Tag fallen. Unsere Hypothese ist, dass es sich hierbei um die initiale Erstellung/den initialen Import des Datensatz handelt. Wir überprüfen dies indem wir dass Startdatum des Datensatzes berechnen und können bestätigen, dass diese Änderungen tatsächlich in der Stunde 0 des ersten Tages des Datensatzes fallen:
section_lines['created_at'].min()
Timestamp('2017-11-21 00:00:00')
Da wir an den fortlaufenden Aktivitäten interessiert sind filtern wir alle Aktivitäten des ersten Tag heraus. Dabei können wir mit <, > arbeiten und gegen einen Datums-String vergleichen.
section_lines = section_lines[section_lines["created_at"] >= '2017-11-22'].copy()
Nun können wir erneut die Analyse nach Uhrzeit machen - dieses Mal als Bar-Chart:
creates_per_hour = section_lines.groupby('hour').size()
plt.bar(creates_per_hour.index, creates_per_hour.values)
plt.xticks(ticks=creates_per_hour.index, labels=creates_per_hour.index)
plt.show()
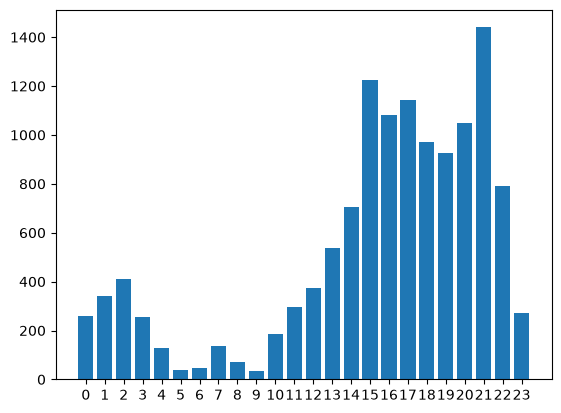
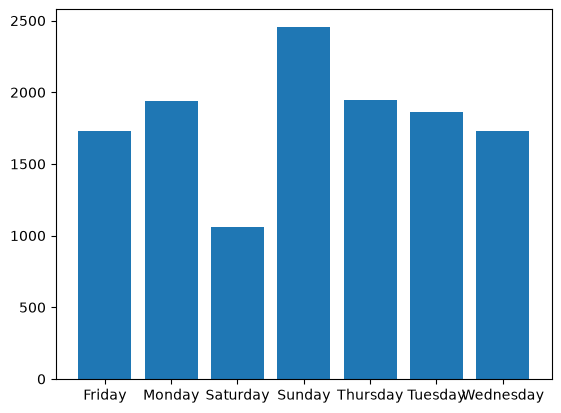
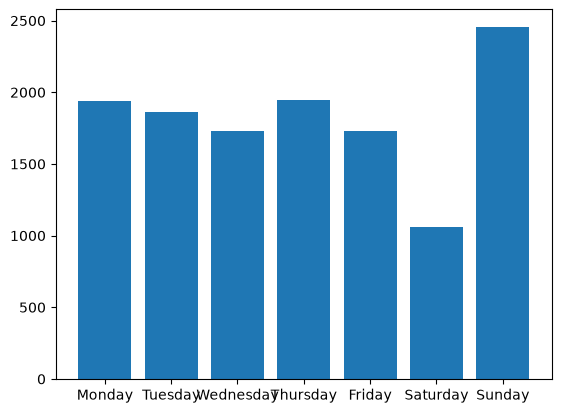
Nun sehen wir eine Häufung am Nachmittag und in den Abendstunden. Vermutlich wird der Datensatz also in der Freizeit erstellt. Um dies weiter zu untersuchen betrachten die die Datensätze pro Wochentag:
section_lines['weekday'] = section_lines['created_at'].dt.day_name()
creates_per_weekday = section_lines.groupby('weekday').size()
plt.bar(x=creates_per_weekday.index, height=creates_per_weekday.values)
plt.show()
14.3. Zeitreihen erzeugen#
Das vorherige Chart zeigt zwar die Aktivitäten nach Wochentag - diese sind jedoch Alphabetisch statt nach ihrer Reihenfolge in der Woche sortiert. Dies ändern wir in dem den Datentyp auf eine sortierte Kategorie ändern. Um diesen Typ und die korrekte Reihenfolge zu erstellen, könnten wir einfach “Monday” bis “Sunday” in der richtigen Reihenfolge in eine Liste tippen. Wir wählen stattdessen einen anderen Weg:
Wir erstellen mit
pd.date_rangeeine Zeitreihe von 7 aneinanderfolgenden Tagen - somit ist die Abdeckung aller Wochentage sichergestelltWir fügen Spalten für
weekday(Durchnummerierung der Wochentage von 0 - Montag bis 6 - Sonntag) unddayname(Strings der Namen der Wochentage)Wir sortieren nach
weekdayund haben dann in der Spaltedaynamedie Wochentage in der korrekten Reihenfolge:
# Erzeuge 7 aufeinanderfolgende Tage (genaues Datum eigentlich egal)
from datetime import date
oneweek = pd.DataFrame(index=pd.date_range(start=date(2021,1,1),periods=7, freq='D'))
oneweek['weekday'] = oneweek.index.weekday
oneweek['dayname'] = oneweek.index.day_name()
oneweek.sort_values('weekday', inplace=True)
ordered_daynames = oneweek['dayname'].values
ordered_daynames

from pandas.api.types import CategoricalDtype
dayname_type = CategoricalDtype(categories=ordered_daynames, ordered=True)
dayname_type
CategoricalDtype(categories=['Monday', 'Tuesday', 'Wednesday', 'Thursday', 'Friday',
                  'Saturday', 'Sunday'],
, ordered=True, categories_dtype=str)
Nun können wir den Datentyp der ‘weekday’-Spalte auf die Kategorie setzen und die Reihenfolge wird bei zukünftigen Analysen berücksichtigt:
section_lines['weekday'] = section_lines['weekday'].astype(dayname_type)
creates_per_weekday = section_lines.groupby('weekday').size()
plt.bar(x=creates_per_weekday.index, height=creates_per_weekday.values)
plt.show()
14.4. Visualisierung nach zwei Dimensionen: Heatmap#
Nun interessiert uns im nächsten Schritt die Kombination aus Wochentag und Uhrzeit. Die Anzahl der Änderungen je Kombination könnten wir nun in 3D anzeigen - solche Charts sind jedoch häufig schwer zu greifen. Stattdessen bietet sich eine Heatmap an - hier wird die dritte Dimension (die Hitze oder Intensität) als Farbe auf einer Farbskala repräsentiert. Seaborn bietet eine praktische Funktion heatmap an, die die Erstellung für uns übernimmt. Als Voraussetzung sollte der Index des DataFrames den gewünschten Zeilten der Heatmap entsprechend und das gleiche gilt für die Spalten des DataFrames und der Heatmap. Dies erreichen wir durch ein Pivotieren des Datensatzes:
weekday_hours = section_lines.pivot_table(index='hour', columns='weekday',
                                          values='line_id', aggfunc='count', fill_value=0)
weekday_hours.head()
| weekday | Monday | Tuesday | Wednesday | Thursday | Friday | Saturday | Sunday |
|---|---|---|---|---|---|---|---|
| hour | |||||||
| 0 | 38 | 54 | 45 | 24 | 15 | 3 | 79 |
| 1 | 57 | 55 | 66 | 102 | 15 | 23 | 23 |
| 2 | 20 | 168 | 44 | 49 | 49 | 64 | 17 |
| 3 | 52 | 47 | 48 | 57 | 21 | 12 | 19 |
| 4 | 17 | 20 | 34 | 9 | 20 | 2 | 26 |
# Erstellen der Heatmap
plt.figure(figsize=(10,6))
sns.heatmap(weekday_hours, annot=True, fmt="d", linewidths=.5,cmap="YlGnBu")
plt.show()
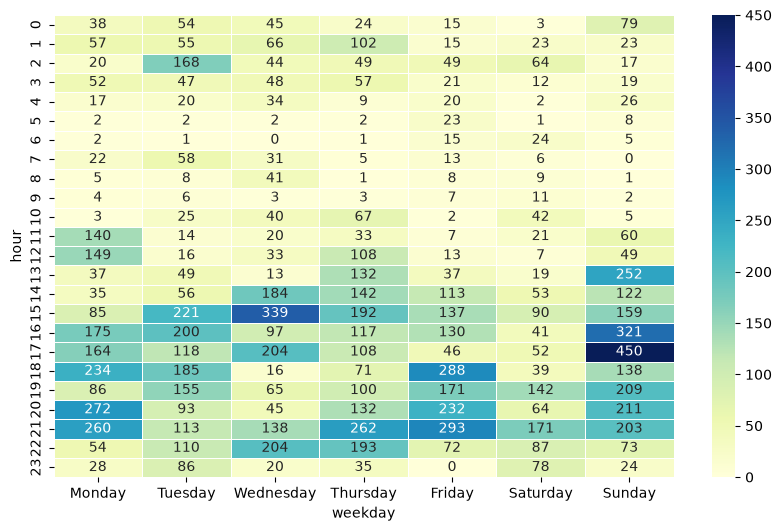
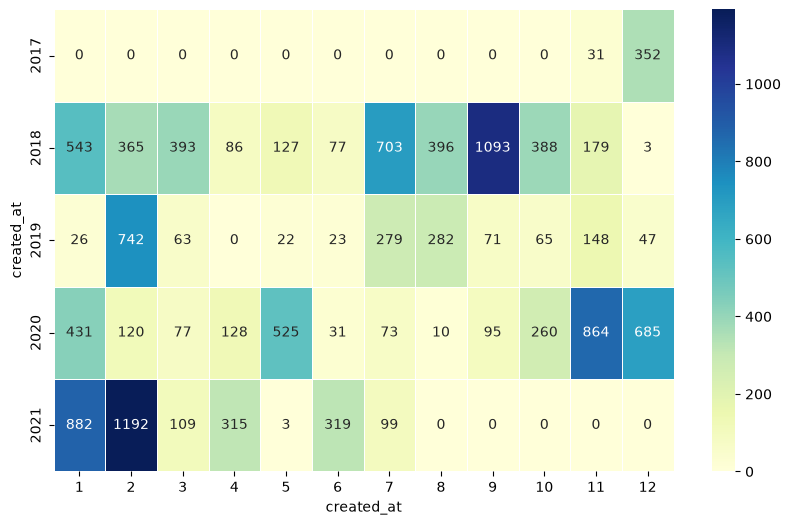
Im vorherigen Schaubild können wir Muster der Benutzer ableiten, wann sie am meisten am am Datensatz gearbeitet haben. Wir können eine Heatmap auch nutzen, um den zeitlichen Verlauf wann wie viele Daten hinzugekommen sind darzustellen. Erstellen Sie hierzu eine Heatmap mit den Jahren als Zeilen und den Monaten als Spalten.
#
14.5. Zeitdifferenzen#
Neben einzelnen Zeitpunkten ist häufig auch der Abstand zwischen verschiedenen Zeitpunkten von Interesse. Dazu gibt es pd.Timedelta. Eine Timedelta entsteht z.B. automatisch wenn zwei Zeitreihen voneinander abgezogen werden:
# Berechne Zeitraum zwischen Erstellung und lezten Update - Rundung auf ganze Tage
delta = (section_lines['updated_at'] - section_lines['created_at']).dt.round('D')
# Zeige die Einträge die einen Abstand von mindestens 1000 Tagen haben
delta[delta >= '1000 days']
id
4389   1212 days
4394   1212 days
dtype: timedelta64[us]
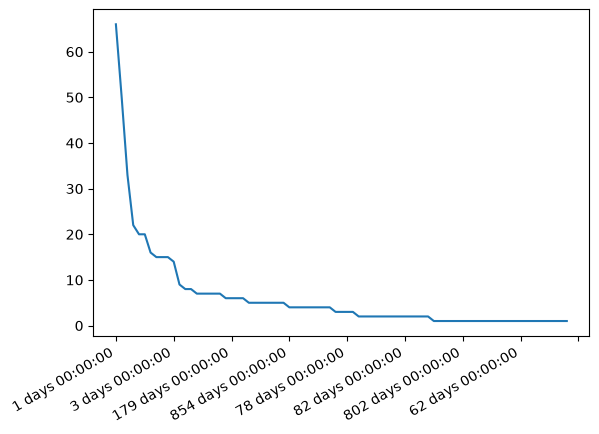
Bei Betrachtung der Werteverteilung fällt auf, dass die meisten Datenpunkte einen Abstand von 0 Tagen haben, d.h. sie wurden wohl noch nie geupdated:
delta.value_counts()
0 days      12223
1 days         66
221 days       50
2 days         33
20 days        22
            ...
64 days         1
58 days         1
14 days         1
50 days         1
273 days        1
Name: count, Length: 80, dtype: int64
Wir plotten nun die Werteverteilung nur der Datensätze, die überhaupt ein Update erfahren haben und sehen eine stark abflachende Kurve. Wir interpretieren dies, dass je mehr Zeit vergeht umso unwahrscheinlicher wird ein Update:
delta[delta >= pd.Timedelta(1, 'D')].value_counts().plot()
plt.show()
Berechnen Sie den maximalen Abstand in dem nichts Neues im Datensatz erstellt wurde. Gehen Sie wie folgt vor:
- Sortieren Sie nach created_at
- Berechnen Sie den Zeitabstand zwischen den einzelnen Daten, nutzen Sie hierfür die diff-Methode
- Geben Sie den größten Zeitabstand aus
#
14.6. Zeitstempel als Index#
Wenn wir einen Zeitstempel als Index setzen, können wir den Datensatz “resamplen”. Dabei wird die Zeitreihe von einer Frequenz auf eine andere umgerechnet. Dabei werden unregelmäßige Zeitstempel (z.B. ein Eintrag diesen Montag, dann zwei Einträge am Mittwoch um 11 und 13 Uhr) auf Intervalle fixe Abstände gebracht (z.B. ein Eintrag jeden Tag oder jede Stunde). Beim Sampling auf eine gröbere Auflösung (z.B. Tag zu Monat) werden die Werte aggregiert, beim Sampling auf eine feinere Auflösung (z.B. Stunde auf Minute) können die Daten interpoliert oder freigelassen werden
Im Folgenden gruppieren wir zuerst auf created_at und zählen die Einträge. created_at wird dabei automatisch als Index gesetzt:
create_events = section_lines.groupby('created_at').agg({'line_id': 'count'})
create_events.max()
line_id    35
dtype: int64
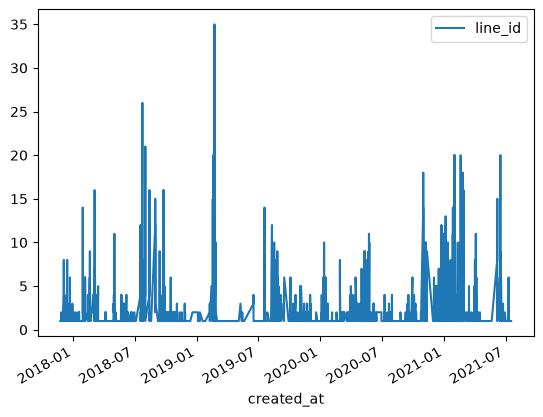
Anhand des Max-Wertes sehen wir, dass zu jeden Zeitpunkt immer nur genau ein Update erfolgt. Das klingt plausibel, wenn wir beachten, dass wir den initialen Import ausgefilter haben und ansonsten die Zeitstempel auf Nanosekunden-Ebene sind. Das entsprechende Chart ist nicht sondern aussagekräftig:
create_events.plot()
plt.show()
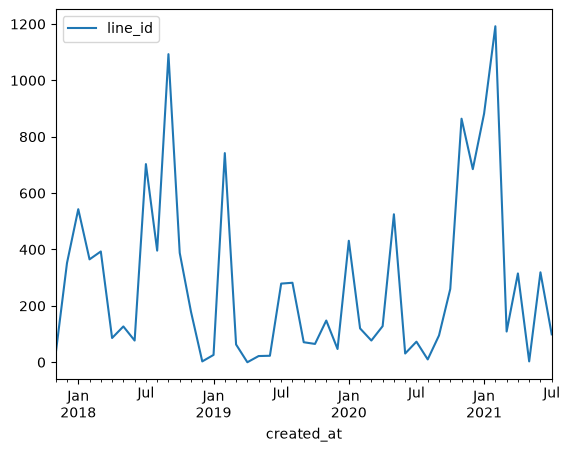
Wenn wir stattdessen ein resampling auf Monatsebene (Parameter ME für month end, d.h. je Monat ein Eintrag zum Monatsende) machen erhalten wir eine interessantere Graphik. Dabei werden mit Hilfe von sum die Änderungen aufaddiert:
create_events.resample('ME').sum().plot()
plt.show()
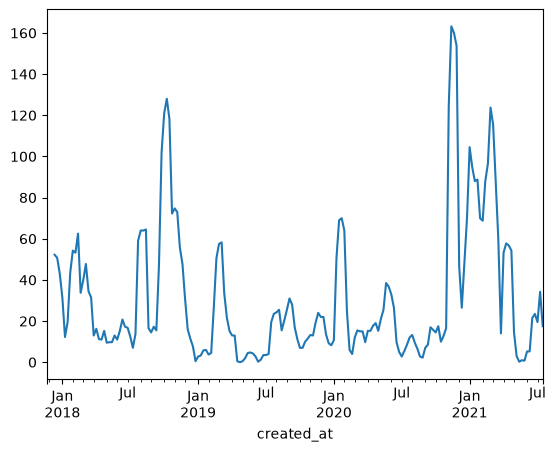
Wir können z.B. auch auf Wochenebene (Parameter W) resampeln und dann einen rollierenden (Methode rolling) Durchschnitt (Methode mean auf dem Ergebnis von rolling) über die letzten 4 Wochen bilden. Dabei erzeugen wir einen Datenpunkt pro Woche - statt wie zuvor pro Monat. Die aufgetragene Zahl bezieht sich immer auf diese Woche und die drei vorhergehenden:
# Immer noch 4 Wochen (ca. 1 Monat) aber rollierend
create_events.resample('W').size().rolling(4).mean().plot()
plt.show()
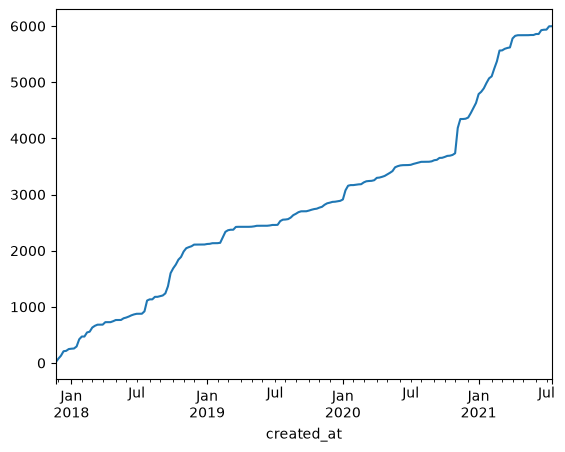
Über die Rollierung kann eine Glättung der Zahlen erreich werden. Eine andere Möglichkeit ist die Größe über die Zeit darzustellen. Im Folgenden ist das als kumulative Summe der neuen Einträge gelöst:
create_events.resample('W').size().cumsum().plot()
plt.show()
14.7. Zeitreihen für Prognosen aufbereiten#
Bisher haben wir Zeitstempel genutzt, um einen Datensatz zu beschreiben. Häufig soll aus einer Zeitreihe aber eine Vorhersage werden, etwa der Umsatz von morgen. Dafür braucht jede Zeile Features, die zum Zeitpunkt der Vorhersage bereits bekannt sind. Bei Zeitreihen stecken die aussagekräftigsten Informationen meist in den vorherigen Zeilen, und genau hier passieren die typischen Fehler.
Wir wechseln dafür zu den Eisverkäufen, die wir im Kapitel Datenbereinigung bereinigt haben. Ziel ist eine Prognose des Tagesumsatzes.
ice = pd.read_csv('data/ice_sales_clean.csv', parse_dates=['date'], index_col='date')
ice.head()
| dayname | temperature | ice_sales_eur | temperature_imputed | |
|---|---|---|---|---|
| date | ||||
| 2021-01-01 | Friday | 0.0 | 403.01 | False |
| 2021-01-04 | Monday | 0.0 | 410.21 | False |
| 2021-01-05 | Tuesday | 0.0 | 390.94 | False |
| 2021-01-06 | Wednesday | 0.0 | 400.85 | False |
| 2021-01-07 | Thursday | 0.0 | 385.97 | False |
Mit einem Zeitstempel als Index lassen sich Zeiträume direkt über Datumsangaben auswählen. Ein Slice mit zwei Daten schließt beide Grenzen ein:
ice.loc['2021-06-01':'2021-06-10']
| dayname | temperature | ice_sales_eur | temperature_imputed | |
|---|---|---|---|---|
| date | ||||
| 2021-06-01 | Tuesday | 24.6 | 1537.11 | False |
| 2021-06-02 | Wednesday | 23.8 | 1457.39 | False |
| 2021-06-03 | Thursday | 23.9 | 1493.17 | False |
| 2021-06-04 | Friday | 23.3 | 1438.49 | False |
| 2021-06-05 | Saturday | 23.6 | 1486.27 | False |
| 2021-06-07 | Monday | 23.1 | 1451.51 | False |
| 2021-06-10 | Thursday | 23.5 | 1462.45 | False |
Eine unvollständige Angabe wählt den ganzen Zeitraum aus, '2021-06' also alle Tage im Juni:
ice.loc['2021-06', 'ice_sales_eur'].sum()
np.float64(33409.399999999994)
Unvollständige Perioden#
Beim Resampling auf Wochen fällt etwas auf, wenn wir neben der Summe auch die Anzahl der Verkaufstage je Woche ausgeben:
ice['ice_sales_eur'].resample('W').agg(['sum', 'count']).head(3)
| sum | count | |
|---|---|---|
| date | ||
| 2021-01-03 | 403.01 | 1 |
| 2021-01-10 | 2372.13 | 6 |
| 2021-01-17 | 2339.93 | 6 |
Der 01.01.2021 war ein Freitag, und Wochen enden bei pandas standardmäßig am Sonntag. Die erste “Woche” besteht deshalb aus einem einzigen Tag, und ihre Summe sieht wie ein Einbruch um über 80 % aus. Dasselbe passiert am Ende einer Zeitreihe und überall dort, wo bei der Bereinigung Tage weggefallen sind. Vor dem Aggregieren lohnt es sich daher immer zu prüfen, ob die Perioden vollständig sind. Unvollständige Perioden am Rand entfernt man in der Regel, bei Lücken in der Mitte kann ein Mittelwert statt einer Summe helfen.
Werte aus der Vergangenheit: Lag-Features#
Die Methode shift verschiebt die Werte einer Series um eine Anzahl von Zeilen. Mit shift(1) bekommt jede Zeile den Wert der vorherigen Zeile, also den Umsatz des letzten Verkaufstags. Solche verschobenen Werte heißen Lag-Features.
Weil der Supermarkt sonntags geschlossen hat und bei der Bereinigung einzelne Tage weggefallen sind, ist die vorherige Zeile nicht immer der Vortag. Soll der Abstand ein fester Zeitraum sein, verschiebt shift(freq='7D') statt der Werte den Index um sieben Tage. Bei der Zuweisung ordnet pandas die Werte dann über den Index zu, und wo es eine Woche vorher keinen Eintrag gab, entsteht NaN:
features = pd.DataFrame({'sales': ice['ice_sales_eur']})
features['sales_prev_day'] = ice['ice_sales_eur'].shift(1)
features['sales_prev_week'] = ice['ice_sales_eur'].shift(freq='7D')
features.loc['2021-06-05':'2021-06-16']
| sales | sales_prev_day | sales_prev_week | |
|---|---|---|---|
| date | |||
| 2021-06-05 | 1486.27 | 1438.49 | 1368.07 |
| 2021-06-07 | 1451.51 | 1486.27 | 1380.52 |
| 2021-06-10 | 1462.45 | 1451.51 | 1493.17 |
| 2021-06-11 | 1442.17 | 1462.45 | 1438.49 |
| 2021-06-14 | 1460.33 | 1442.17 | 1451.51 |
| 2021-06-15 | 1437.24 | 1460.33 | NaN |
| 2021-06-16 | 1502.07 | 1437.24 | NaN |
Am 07.06. steht als letzter Verkaufstag der Samstag, 05.06. Am 15. und 16.06. fehlt der Vorwochenwert, weil der 08. und 09.06. bei der Bereinigung entfernt wurden. Ganz am Anfang der Zeitreihe gibt es naturgemäß keine Vergangenheit, dort sind die Lag-Features immer leer.
Rollierende Werte als Features#
Einen rollierenden Durchschnitt haben wir oben zum Glätten verwendet. Als Feature für eine Prognose ist er ebenfalls nützlich, aber nur, wenn er ausschließlich vergangene Werte enthält. rolling(6).mean() berechnet für jede Zeile den Durchschnitt aus dieser und den fünf vorherigen Zeilen. Der Umsatz des Tages, den wir vorhersagen wollen, steckt also schon im Feature. Richtig ist, zuerst zu verschieben und dann zu rollieren:
features['rolling_wrong'] = ice['ice_sales_eur'].rolling(6).mean()
features['sales_prev_6_days'] = ice['ice_sales_eur'].shift(1).rolling(6).mean()
features.loc['2021-06-10':'2021-06-16', ['sales', 'rolling_wrong', 'sales_prev_6_days']]
| sales | rolling_wrong | sales_prev_6_days | |
|---|---|---|---|
| date | |||
| 2021-06-10 | 1462.45 | 1464.880000 | 1477.323333 |
| 2021-06-11 | 1442.17 | 1462.343333 | 1464.880000 |
| 2021-06-14 | 1460.33 | 1456.870000 | 1462.343333 |
| 2021-06-15 | 1437.24 | 1456.661667 | 1456.870000 |
| 2021-06-16 | 1502.07 | 1459.295000 | 1456.661667 |
In den Zahlen ist der Unterschied unauffällig. Ein Modell mit der falschen Variante würde aber auf eine Information zugreifen, die es bei einer echten Prognose nicht hat, und in der Evaluation besser aussehen, als es im Betrieb ist. Das ist ein Beispiel für Leakage des Zielwerts, wie wir es im Kapitel zur Modeling-Phase von CRISP-DM beschrieben haben.
features = features.drop(columns=['rolling_wrong'])
Dieselbe Frage stellt sich bei allen anderen Features: Was weiß ich zum Zeitpunkt der Vorhersage? Wochentag und Monat des Prognosetags sind bekannt und lassen sich aus dem Index extrahieren. Für lineare Modelle wären sie anschließend per One-Hot-Encoding zu kodieren, wie im Kapitel Feature Engineering beschrieben. Die Temperatur des Prognosetags kennen wir am Vortag dagegen nur als Wettervorhersage. Trainieren wir mit der gemessenen Temperatur, ist das Modell im Test genauer als später im Betrieb, wo es mit einer ungenaueren Vorhersage arbeiten muss.
features['weekday'] = features.index.dayofweek
features['month'] = features.index.month
features.head()
| sales | sales_prev_day | sales_prev_week | sales_prev_6_days | weekday | month | |
|---|---|---|---|---|---|---|
| date | ||||||
| 2021-01-01 | 403.01 | NaN | NaN | NaN | 4 | 1 |
| 2021-01-04 | 410.21 | 403.01 | NaN | NaN | 0 | 1 |
| 2021-01-05 | 390.94 | 410.21 | NaN | NaN | 1 | 1 |
| 2021-01-06 | 400.85 | 390.94 | NaN | NaN | 2 | 1 |
| 2021-01-07 | 385.97 | 400.85 | NaN | NaN | 3 | 1 |
Trainings- und Testdaten zeitlich trennen#
Bei Zeitreihen werden Trainings- und Testdaten an einer Datumsgrenze getrennt: Alles davor dient dem Training, alles danach dem Test. Das bildet die echte Situation ab, in der aus der Vergangenheit die Zukunft vorhergesagt wird. Mit Lag-Features wäre eine zufällige Aufteilung besonders problematisch. Der Umsatz eines Testtags stünde dann als Lag-Feature in einer Trainingszeile am Folgetag, und das Modell hätte den Zielwert indirekt schon gesehen.
Zeilen mit leeren Lag-Features entfernen wir, da viele Verfahren damit nicht umgehen können:
split_date = '2021-10-01'
train = features[features.index < split_date].dropna()
test = features[features.index >= split_date].dropna()
print(f'Training: {len(train)} Tage bis {train.index.max():%d.%m.%Y}')
print(f'Test:     {len(test)} Tage ab {test.index.min():%d.%m.%Y}')
Training: 220 Tage bis 30.09.2021
Test:     79 Tage ab 01.10.2021
Schon ohne Modell können wir eine erste Prognose bewerten: Der Umsatz ist so hoch wie am letzten Verkaufstag. Die mittlere absolute Abweichung dieser einfachen Regel auf den Testdaten ist ein Maßstab, den jedes spätere Modell schlagen muss. Solche Vergleichsmaße heißen Baselines, im Kapitel Evaluation kommen wir darauf zurück.
mae = (test['sales'] - test['sales_prev_day']).abs().mean()
print(f'Mittlere absolute Abweichung "wie am letzten Verkaufstag": {mae:.2f} Euro')
Mittlere absolute Abweichung "wie am letzten Verkaufstag": 36.29 Euro
Im Kapitel Data Understanding hat sich herausgestellt, dass dem Fachbereich eine Prognose auf Wochenebene genügt. Bereiten Sie die Daten entsprechend auf:
- Berechnen Sie je Woche den durchschnittlichen Tagesumsatz und die Anzahl der Verkaufstage. Entfernen Sie Wochen mit weniger als drei Verkaufstagen
- Erstellen Sie zwei Features: den durchschnittlichen Tagesumsatz der Vorwoche und den Durchschnitt der vier Vorwochen
- Trennen Sie Trainings- und Testdaten am 01.10.2021 und berechnen Sie für beide Features die mittlere absolute Abweichung auf den Testdaten, wenn man sie direkt als Prognose verwendet. Wie erklären Sie das Ergebnis?
#